
VoxCPM 是 OpenBMB 开源的语音合成模型。当前主版本 VoxCPM2 为 2B 参数,基于 MiniCPM-4 骨干,用 200 多万小时多语言语音训练,官方称支持 30 种语言、音色设计、可控克隆和 48kHz 输出。它采用 tokenizer-free 的扩散自回归架构,直接生成连续语音表示,权重与代码以 Apache-2.0 发布。Python 包名是 voxcpm,模型可从 Hugging Face 或 ModelScope 下载。本文按官方 README 整理,未在本机完整实测;性能数字为 README 参考值,实际以硬件和版本为准。
不用 tokenizer 的 TTS
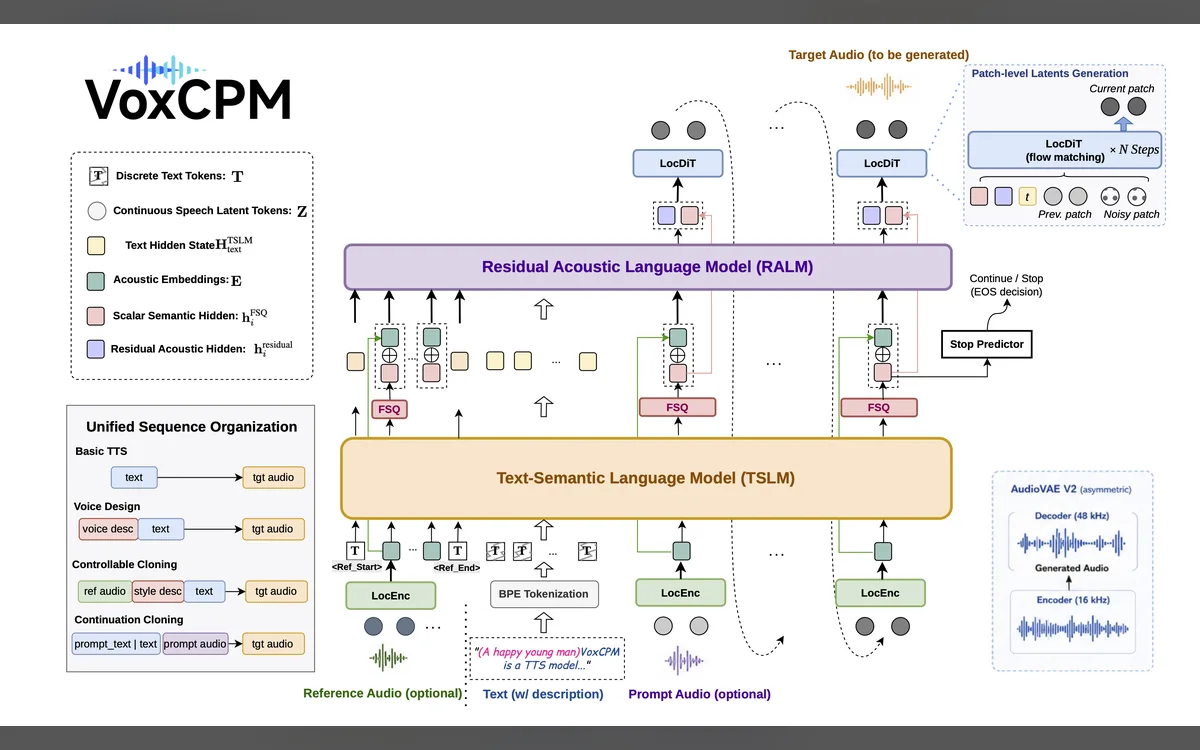
常见 TTS 先把音频离散成 token,再让语言模型预测 token。VoxCPM 跳过这一步,在 AudioVAE V2 的潜空间里工作,流程分为 LocEnc、TSLM、RALM、LocDiT 四段。README 的说法是,这样能保留更丰富的韵律和表现力,并原生输出 48kHz 音频;输入 16kHz 参考音频也能直接得到 48kHz 结果,不需要外接超分。
对使用者来说,架构细节不一定重要,重要的是它把“文本转语音”和“从参考音频延续音色”放在同一个模型里,减少了拼接多个模型的工程量。README 还提供流式接口 generate_streaming,适合边生成边播放的对话场景。
三种用法
直接合成:安装 voxcpm 包并准备好模型后,Python API 只需几行:
pip install voxcpm |
from voxcpm import VoxCPM |
音色设计:不需要参考音频,把描述写在文本开头的括号里,例如 (A young woman, gentle and sweet voice)Hello...,模型会按性别、年龄、语气、情绪和语速生成新音色。README 说明它支持 30 种语言,输入文本不需要语言标签。
可控克隆:给一段参考音频克隆音色,还能在文本前加风格指令调整情绪和速度;如果同时提供参考音频和逐字稿,把音频传给 prompt_wav_path、文本传给 prompt_text,为了相似度再把同一段音频传给 reference_wav_path,则走“终极克隆”,更完整地保留音色、节奏和表达细节。
CLI 把常用操作包好了:
voxcpm design --text "..." --output out.wav |
批量模式适合把脚本按行喂进去,一次生成多条旁白;--timestamps 还能输出词级或字符级时间戳,方便后续对齐字幕,但需要先安装 voxcpm[timestamps]。README 说明字符时间戳是由词对齐推导的,属于尽力而为。
部署与性能
安装要求 Python 3.10 到 3.12、PyTorch 2.5 以上、CUDA 12 以上。官方给出的显存需求约为 8 GB(VoxCPM2),RTX 4090 上 RTF 约 0.30,经 Nano-vLLM 加速约 0.13。这些是 README 的参考值,实际取决于文本长度、批大小和硬件。高并发场景可以用 Nano-vLLM 或 vLLM-Omni 部署,后者提供 OpenAI 兼容接口和流式分块。
没有 GPU 时也能用 CPU 或 Apple Silicon 的 MPS 跑 Web Demo:python app.py --port 8808,再用 --device 指定 auto、cpu、mps 或 cuda。速度要自己评估,长文本在 CPU 上通常不适合实时场景。
微调
README 说明支持全量 SFT 和 LoRA 微调,5 到 10 分钟音频就能适配特定说话人、语言或领域。对需要固定品牌声音的团队,这比每次靠提示词碰运气更稳;但微调需要准备转写、切分和训练环境,仍是一项工程任务。LoRA 的好处是参数少、可以热切换,适合为多个说话人维护一套底座。
典型场景
一个做多语言产品视频的团队,用 VoxCPM2 生成中文、英文、日文旁白,再用音色设计为不同角色创建声音。固定主播的音色通过 LoRA 微调锁定,脚本更新后批量合成,最后由剪辑工具对齐画面。相比逐条找配音演员,成本和时间更可控,声音素材也留在自己的机器上。
和商业 TTS 的差别
ElevenLabs 这类商业服务提供成熟的托管 API、丰富的控制项和按量计费;VoxCPM 把模型权重交给自己部署,数据不出本机,长期成本主要是 GPU。Edge TTS 免费,但没有音色设计和克隆能力。选择取决于你是否愿意维护推理环境,以及对声音授权和数据隐私的要求。
风险与限制
README 明确禁止用 VoxCPM 冒充他人、诈骗或制造虚假信息,AI 生成内容应清楚标注。音色设计和可控克隆在不同运行之间会有波动,官方建议生成 1 到 3 次再挑结果。30 种语言之外的质量没有保证;高保真克隆涉及真人声音,必须取得授权并遵守当地法律。模型较大,显存不足时推理会失败,改用 CPU 则速度明显下降。README 也建议生产部署前针对具体场景做安全评估。
适合谁
适合需要多语言旁白、角色音色、私有部署或声音克隆(已获授权)的内容团队、游戏和 Agent 开发者,以及愿意自己维护 GPU 推理的工程团队。只需要偶尔把文字转成语音、且不想碰命令行的用户,用系统自带朗读或商业 TTS 更直接。
入口
- 仓库:OpenBMB/VoxCPM
- 文档:voxcpm.readthedocs.io
- 在线体验:Hugging Face Space
- 模型:Hugging Face / ModelScope
- 许可证:Apache-2.0