
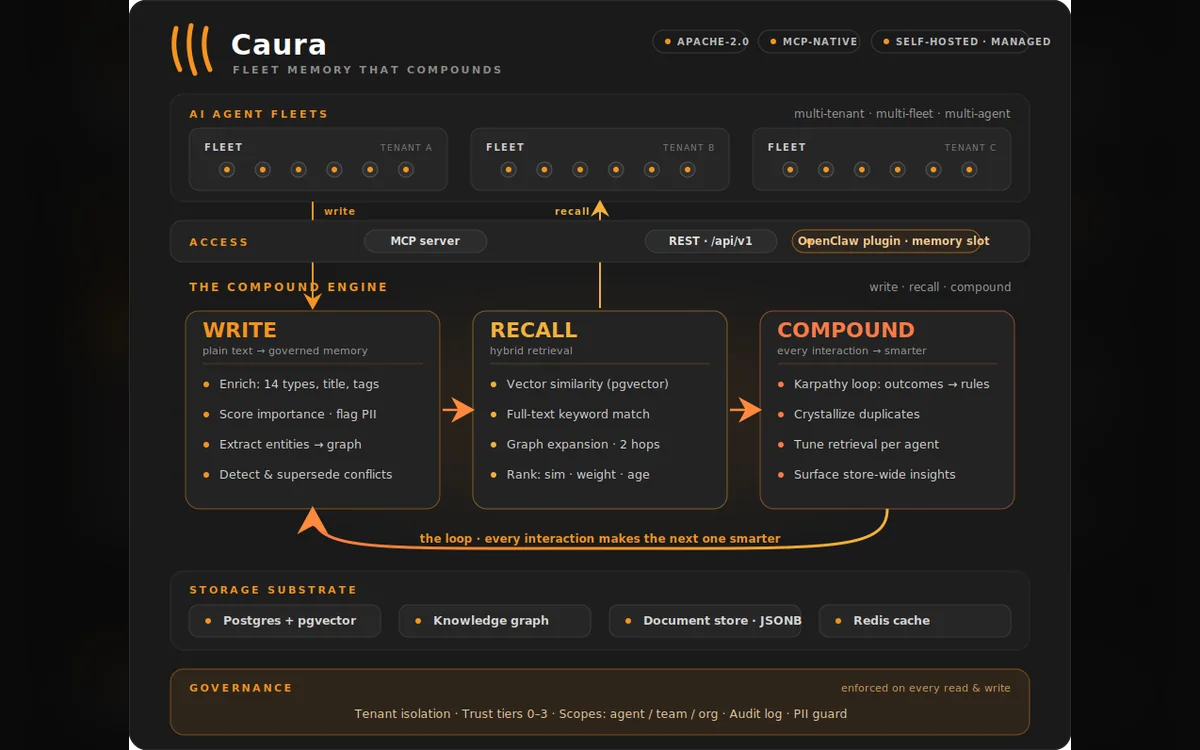
caura 是 caura-ai 团队维护的共享记忆层,Apache-2.0 许可,原名 MemClaw。它面向的不是单个聊天机器人,而是一组多租户、多 Agent 的协作环境:每个 Agent 把学到的东西写进来,其他 Agent 按权限召回,失败和成功的结果再反哺记忆。README 把这条循环概括为 write、recall、compound。
让一组 Agent 共用一本可审计的账
一个 Agent 工作时,把上下文塞进提示词就够用;Agent 一多,问题就变成:部署 Agent 学到的回滚命令,事故处理 Agent 怎么知道?哪些记忆能跨团队读?谁在什么时候删了一条规则?caura 把这些问题收进一个服务,写入时打上租户、可见范围和信任级别,召回时按权限过滤,所有写删和状态变化留审计记录。
写入、召回与治理
每次写入只要求一个 content 字段,服务端会推断记忆类型、标题、摘要、重要度,标记 PII 并抽取实体。记忆分七种类型,Agent 也可以批量写入,单次最多 100 条。
召回采用混合检索:pgvector 语义相似度、全文关键词和知识图谱扩展一起排序,图谱最多扩两跳。若结果里同时出现被取代的旧记忆和替代它的新记忆,新记忆会排在旧记忆紧邻的上方,避免过期信息压过修正。写入时还会做矛盾检测,发现冲突就生成替代关系并保留链路。
治理是这套系统与普通向量库差别最大的地方。每个租户在数据库层面隔离;每条记忆标记为 scope_agent、scope_team 或 scope_org,跨 fleet 召回需要授权;Agent 有四级信任层级,控制跨 fleet 的读、写和删除;所有操作进审计日志。PII 检测会把 contains_pii 和类型写进元数据,但它是提示,不是合规认证。
最小自托管
不配置模型 Key 也能先跑起来。standalone 模式是单租户、关闭鉴权,记忆不做向量化,只能按关键词检索:
git clone https://github.com/caura-ai/caura.git |
写入和搜索可以直接用 curl 验证:
# 写一条记忆;standalone 模式下 API Key 固定为 standalone |
需要语义召回时再配置 embedding 供应商。MCP 客户端可以直接接本地服务:
claude mcp add --transport http -s user caura http://localhost:8000/mcp --header "X-API-Key: standalone" |
以上命令按官方 README 整理,未在本机完整实测;配置供应商、反向代理和生产鉴权要另看自托管文档。
部署 Agent 与事故 Agent
平台团队有两个 Agent:deploy-agent 把“用 deployctl 回滚 auth-service”的经验以 scope_team 写入 platform fleet;几周后 incident-agent 在处理故障时用 caura_recall 问“怎么回滚 auth-service”,结果里带着作者和信任级别。需要跨团队共享时,把记忆提升到 scope_org,由信任层级决定谁能读。这样的分工让经验只写一次,而不是每个 Agent 各自踩坑。
与 Mem0、Zep、Letta 的定位差异
单个 Agent 用 Mem0、Zep 或 Letta 都能工作,caura 自己也不否认这一点。差异出现在 Agent 数量增加之后:多 fleet、信任层级、跨厂商共享、矛盾检测和按 Agent 调参,是 README 对比表里强调的能力。那张表基于厂商对公开文档的解读,选型时仍应逐项核对,不能把它当成第三方评测。
性能方面,README 公布了 LoCoMo 和 LongMemEval 的结果,同时注明这些公开基准测的是单 Agent、单用户的长对话,不能直接代表多 Agent 治理场景。延迟和召回质量要在自己的数据上验证。
记忆放大的隐私与复杂度
共享记忆把隐私风险也放大了:一条含个人信息的记忆如果被错误地设成 scope_org,影响范围比单机聊天记录大得多。PII 标记、租户隔离和审计只能降低风险,保留周期、删除流程和访问策略仍要自己设计。
自托管要维护 Postgres、pgvector、Redis、API 和调度器,小项目会觉得重。standalone 模式省掉了鉴权和语义检索,适合试用,不适合生产。记忆写入越多, crystallization 和矛盾检测带来的后台任务也越多,需要观察成本和延迟。
什么时候值得上
适合已有多个 Agent、需要共享事实和操作经验,并且在意权限与审计的团队,例如平台运维、客服自动化或多产品线 Agent 平台。只有一个 Agent、数据量很小的个人项目,用更轻的记忆库或直接拼上下文更合适。
官方入口
- 仓库:caura-ai/caura
- 官网:caura.ai
- 文档:caura.ai/docs
- 许可:以仓库为准,README 标注 Apache-2.0